태그
LLM활용
- 글 6편
AI 실전 판단 설계와 인간 멈춤선: Code가 도구이고 LLM이 운영할 때 인간이 책임지는 법
핵심 명제: “도구는 Code로 구현되고, Code를 LLM이 운영하며, 최종 가치와 판단의 책임은 인간이 소유한다.” — 1. 프롬프트 요령의 한계와 판단의 공백 최근 수많은 조직이 AI 에이전트와 LLM을 실무에 도입하고 있습니다. 하지만 현장에서 마주하는 진짜 문제는 “프롬프트를 얼마나 유려하게 작성하는가”가 아닙니다. 실무의 성패를 가르는 본질은 “무엇을…
AI의 오류를 줄이고, 발견했을 때 고칠 수 있게 하기
🧠 왜 우리는 LLM의 환상을 없애지 않는가 Llm의 할루시네이션은 관리하는거다 3 ― 관리 가능한 LLM 추론 전략(Mitigatable Reasoning) 이라는 현실적 선택 1. 문제 제기: 왜 “사고처럼 보이는 것”이 문제가 되는가? 대형 언어모델(LLM)은 사고하지 않는다. 그러나 인간은 그 출력을 보면 자꾸 ‘사고하고 있는 것처럼’ 느낀다. 그…
AI의 답을 내 판단 능력으로 연결하려면
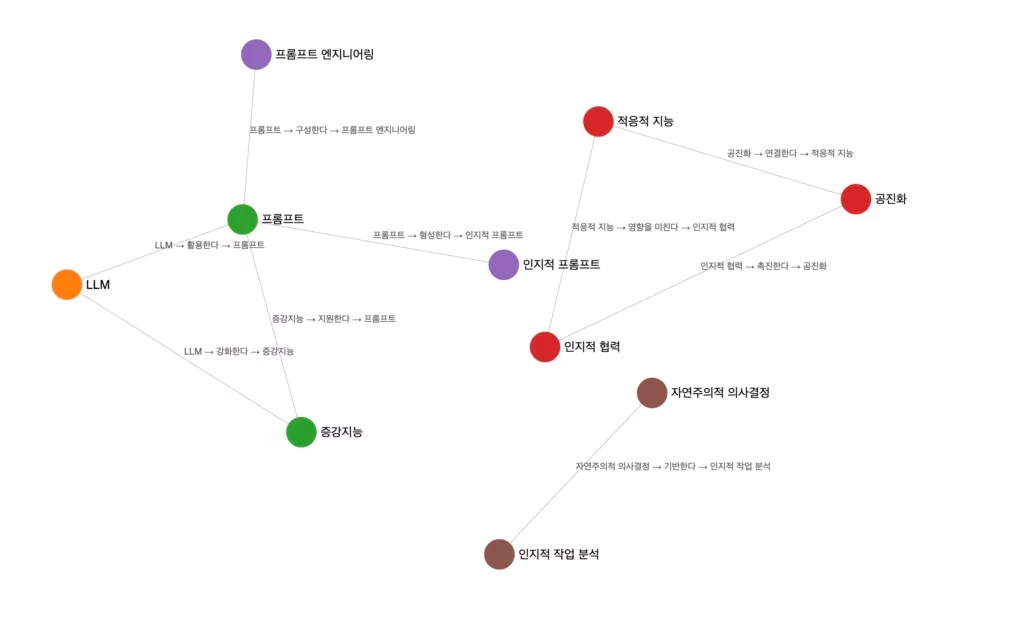
LLM을 통한 성과의 에센스 “증강지능과 인지적 프롬프트” Llm을 통한 성과의 에센스 “증강지능과 인지적 프롬프트” 3 LLM과 협력하는 방식이 성과를 결정합니다 LLM을 단순한 자동화 도구가 아닌 증강지능(Augmented Intelligence)으로 인식할 때, 우리는 그 진정한 가치를 온전히 실현할 수 있습니다. 더글라스 엥겔바르트가 강조한 증강지능의 개념은 인간과 AI가 협력하여 서로의…
불완전한 재료로 AI와 생각하기
“Garbage in, But Gold out”: 인간과 AI의 공진화를 통한 새로운 가치 창출 1. 인간은 본디 “쓰레기”에서 “금”을 캐내는 연금술사 인간은 불완전하고 모호하며, 때로는 “쓰레기”처럼 보이는 정보의 홍수 속에서도 놀라운 능력을 발휘합니다. 바로, 그 “쓰레기” 더미 속에서 보석과 같은 의미와 가치를 발견하고, “금”과 같은 눈부신 통찰을…
검색형 AI가 찾아준 답, 어디까지 확인한 것일까
할루시네이션 위험 증가– Search GPT 와 Perplexity 는 아직, 실시간 스크래핑(크롤링)을 하지 않습니다. LLM 미신은 할루시네이션을 유발하고, LLM의 효용 가치를 떨어뜨립니다. 실시간 데이터 수집의 방식은 두 갈래로 나뉩니다. 실시간 스크래핑과 실시간 쿼리 방식, 이 두 가지는 표면적으로는 유사해 보이지만, 그 성격은 다릅니다. 만약 우리가 실시간…
AI가 전문가처럼 답할 때, 무엇을 확인해야 할까
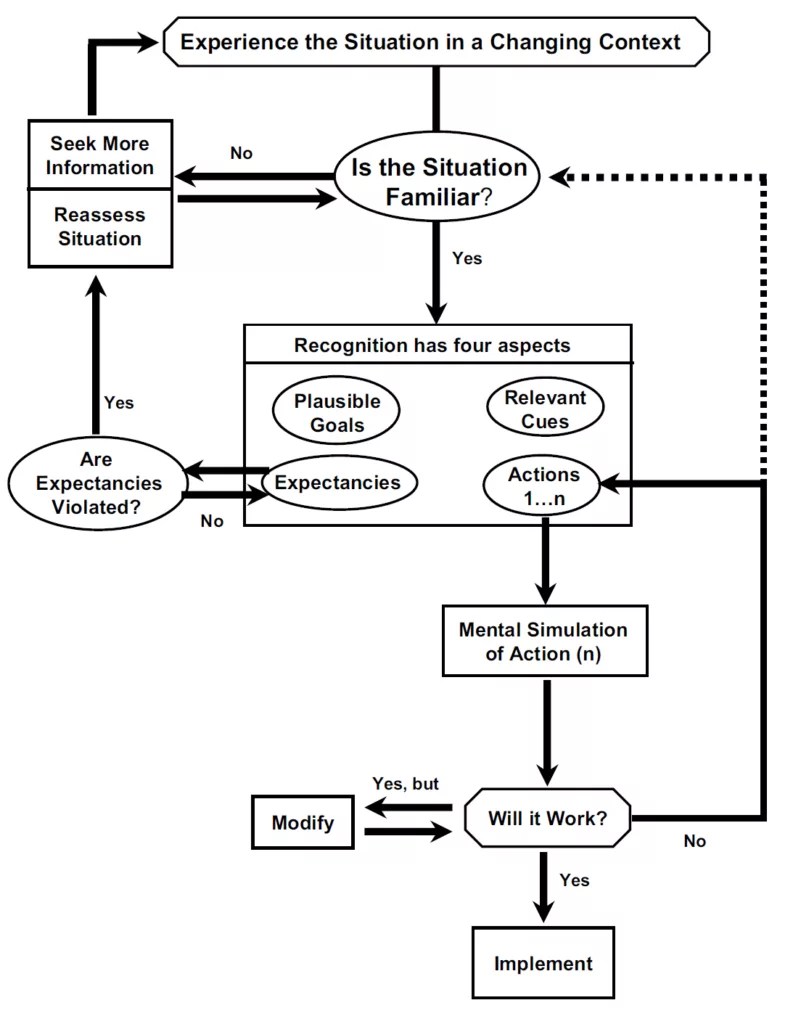
– 목록 AI 기술, 특히 대형 언어 모델(LLM)은 방대한 데이터를 기반으로 다양한 작업을 수행하며, 여러 분야에서 전문가를 대체할 수 있을지에 대한 논의가 활발합니다. 그러나 자연주의적 의사결정(NDM) 연구에서 인간 전문가의 의사결정 과정을 살펴보면, LLM이 전문가를 대체하기에는 여러 가지 한계가 분명히 드러납니다. 특히 RPD 모델(Recognition-Primed Decision Model)을…